محول الرؤية
المحتويات
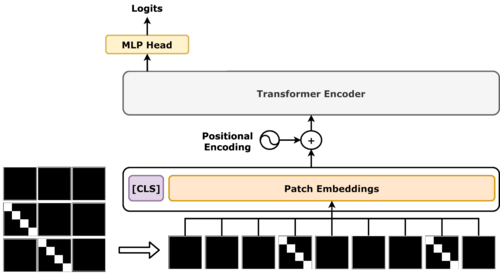
في البداية، محول الرؤية (ViT) هو محول مصمم لـالرؤية الحاسوبية. ويحلل ViT صورة الإدخال إلى سلسلة من الرقع (بدلًا من تحليل النص إلى رموز)، ثم يحوّل كل رقعة إلى متجه، ويُسقطه إلى بُعد أصغر بضرب مصفوفي واحد. ثم تُعالَج تضمينات هذه المتجهات بواسطة مُرمِّز محول كما لو كانت تضمينات رموز. وتعرض الأقسام التالية جوانب أخرى من الموضوع.
في هذا الإطار، وبعد نشره، اقتُرحت له متغيرات كثيرة، منها معماريات هجينة تجمع خصائص من محولات الرؤية ومن الشبكات العصبية الالتفافية. ووجدت محولات الرؤية تطبيقات في التعرف على الصور، وتقسيم الصور، والتنبؤ بالطقس، والقيادة الذاتية.
وفي السياق ذاته، صُممت محولات الرؤية لتكون بدائل لـالشبكات العصبية الالتفافية (CNN) في تطبيقات الرؤية الحاسوبية. ولها انحيازات استقرائية مختلفة، واستقرار مختلف في التدريب، وكفاءة مختلفة في استغلال البيانات. وبالمقارنة مع الشبكات العصبية الالتفافية، فإن محولات الرؤية أقل كفاءة من حيث البيانات، لكنها أعلى سعة. وبعض أكبر نماذج الرؤية الحاسوبية الحديثة هي من نوع ViT، مثل نموذج يضم 22 مليار معامل.
انظر أيضاً
محول (بنية تعلم عميق)
التاريخ
في هذا الإطار، وتبع ذلك تفاعل متبادل بين المقاربة السابقة القائمة على الشبكات العصبية الالتفافية ومقاربة ViT.
كذلك، وفي سنة 2020، جرى تكييف محول قائم على المُرمِّز فقط للرؤية الحاسوبية، منتجًا ViT، الذي بلغ مستوى متقدمًا في تصنيف الصور، متجاوزًا هيمنة الشبكات العصبية الالتفافية السابقة. ثم وسّع المُرمِّز الذاتي المقنّع (2022) من قدرات ViT ليعمل في التدريب غير المراقَب. وقد حفّز محول الرؤية والمُرمِّز الذاتي المقنّع بدورهما تطورات جديدة في الشبكات العصبية الالتفافية.
في هذا الإطار، وفي عام 2021، اقتُرحت بعض المتغيرات المهمة لمحولات الرؤية. وكانت هذه المتغيرات تهدف أساسًا إلى زيادة الكفاءة أو الدقة أو الملاءمة لمجال محدد. وقد حسّنت دراستان كفاءة ViT ومتانته بإضافة شبكة عصبية التفافية بوصفها معالجًا مسبقًا. أما Swin Transformer فقد حقق نتائج على مستوى الحالة الفنية في بعض مجموعات بيانات كشف الكائنات مثل COCO، باستخدام نوافذ انتباه منزلقة شبيهة بالالتفاف، وباستخدام المعالجة الهرمية المعروفة في الرؤية الحاسوبية الكلاسيكية.
ومن ناحية أخرى، قُدمت المحولات في المقالة العلمية الانتباه هو كل ما تحتاجه (2017)، ووجدت استخدامًا واسعًا في معالجة اللغات الطبيعية. وقد طبقت ورقة عام 2019 أفكار المحول على الرؤية الحاسوبية. وعلى وجه التحديد، انطلقت من شبكة عصبونية متبقية ResNet، وهي شبكة عصبية التفافية قياسية للرؤية الحاسوبية، واستبدلت جميع أنوية الالتفاف بآلية الانتباه الذاتي الموجودة في المحول. وقد أدى ذلك إلى أداء أفضل، لكنه لا يُعد محول رؤية.
المتغيرات
من جانب آخر، تقيس المحولات العلاقات بين أزواج الرموز المدخلة (الكلمات في حالة السلاسل النصية)، وهو ما يُطلق عليه اسم الانتباه. تكون التكلفة تربيعية بالنسبة لعدد الرموز. أما بالنسبة للصور، فتعد البكسل هي وحدة التحليل الأساسية. ومع ذلك، فإن حساب العلاقات لكل زوج من البكسلات في صورة نموذجية يعد أمراً مكلفاً جداً من حيث الذاكرة والحوسبة. بدلاً من ذلك، يحسب محول الرؤية (ViT) العلاقات بين البكسلات في أقسام صغيرة مختلفة من الصورة (مثلًا، 16×16 بكسل)، بتكلفة أقل بكثير. يتم وضع هذه الأقسام (مع التضمينات الموضعية) في تسلسل. التضمينات عبارة عن متجهات قابلة للتعلم. يتم ترتيب كل قسم في تسلسل خطي ويُضرب في مصفوفة التضمين. تُغذى النتيجة، مع التضمين الموضعي، إلى المحول.
علاوةً على ذلك، كان محول الرؤية (ViT) الأصلي عبارة عن محول (Transformer) يتكون من مشفر فقط (encoder-only)، تم تدريبه بإشراف لتوقع تصنيف الصورة من خلال رقع (patches) الصورة. وكما هو الحال في نموذج بيرت (BERT)، فإنه يستعمل رمزاً مميزاً خاصاً في جانب الإدخال، ويُستعمل متجه المخرجات المقابل كمدخل وحيد لرأس الإدراك متعدد الطبقات (MLP) النهائي. هذا الرمز الخاص هو عبارة عن حيلة معمارية للسماح للنموذج بضغط جميع المعلومات ذات الصلة بتوقع تصنيف الصورة في متجه واحد.
محول الرؤية الأصلي (Original ViT)
كذلك، وجدت المحولات تطبيقاتها الأولية في مهام معالجة اللغات الطبيعية، كما هو موضح في النماذج اللغوية مثل بيرت (BERT) وجي بي تي-3 (GPT-3). على النقيض من ذلك، يستعمل نظام معالجة الصور النموذجي شبكة عصبية التفافية (CNN). وتشمل المشاريع المعروفة في هذا المجال إكسبشن (Xception)، وريزنت (ResNet)، وإفيشنت نت (EfficientNet)، ودينس نت (DenseNet)، وإنسبشن (Inception).
متغيرات أخرى
وفي هذا الصدد، عادةً، يستعمل محول الرؤية (ViT) أحجام رقع أكبر من نويات CNN القياسية (والتي تتراوح من 3×3 إلى 7×7). يُعد ViT أكثر حساسية لاختيار المُحسِّن (optimizer)، والمعلمات الفائقة (hyperparameters)، وعمق الشبكة. تساعد المعالجة المسبقة بطبقة من المرشحات الالتفافية الأصغر حجماً والمتداخلة (حيث تكون الخطوة stride أقل من الحجم) على تحسين الأداء والاستقرار.
إضافةً إلى ذلك، يبدو أن هذا السلوك المختلف ينبع من الانحيازات الاستقرائية المختلفة التي يمتلكها كل منهما.
كذلك، في معمارية (المحول داخل المحول - Transformer in Transformer)، تُطبق كل طبقة طبقةَ محول رؤية على كل تضمين لرقعة الصورة، وتضيف الرموز الناتجة مرة أخرى إلى التضمين، ثم تطبق طبقة محول رؤية أخرى.
مقارنة مع الشبكات العصبية الالتفافية (CNNs)
من جهة ثانية، تُطبق CNN نفس المجموعة من المرشحات لمعالجة الصورة بأكملها. هذا يسمح لها بأن تكون أكثر كفاءة في استخدام البيانات وأقل حساسية للاضطرابات المحلية. بينما يُطبق ViT الانتباه الذاتي، مما يسمح له بالتقاط العلاقات بعيدة المدى بين الرقع بسهولة. كما أنها تتطلب المزيد من البيانات للتدريب، ولكن يمكنها استيعاب بيانات تدريب أكثر مقارنة بـ CNN، والتي قد لا يتحسن أداؤها بعد التدريب على مجموعة بيانات كبيرة بما فيه الكفاية. يبدو كذلك أن ViT أكثر قوة ومرونة في مواجهة تشوهات الصورة المُدخلة مثل الرقع التنافسية أو التبديلات.
ومن ناحية أخرى، تشمل الأمثلة الأخرى المحول البصري (visual transformer)، و CoAtNet، و CvT، ومحول الرؤية عالي الكفاءة في البيانات (DeiT)، إلخ.
التحسينات المعمارية
وفي السياق ذاته، استوحى المشفر التلقائي المقنع فكرته من المشفرات التلقائية المزيلة للضوضاء ومشفرات السياق. وهو يتكون من محولي رؤية (ViTs) متصلين من البداية للنهاية. يأخذ المحول الأول ("المشفر") رقع الصورة مع التشفير الموضعي، ويُخرج متجهات تمثل كل رقعة. يأخذ المحول الثاني (ويُسمى "فك التشفير"، على الرغم من أنه لا يزال محولاً يتكون من مشفر فقط) المتجهات مع التشفير الموضعي ويُخرج رقع الصورة مرة أخرى.
علاوةً على ذلك، أثبتت الأوراق البحثية اللاحقة أن كل من (GAP) و (MAP) يقدمان أداءً أفضل من التجميع الشبيه بنموذج بيرت (BERT). تم اقتراح متغير من (MAP) باسم انتباه الفئة (class attention)، والذي يطبق (MAP)، ثم تغذية أمامية، ثم (MAP) مرة أخرى.
من جانب آخر، تجميع الانتباه متعدد الرؤوس (MAP) يُطبق كتلة انتباه متعددة الرؤوس على عملية التجميع. على وجه التحديد، فإنه يأخذ كمدخلات قائمة من المتجهات $x_1, x_2, \dots, x_n$، والتي يمكن اعتبارها متجهات المخرجات لطبقة من طبقات محول الرؤية. يكون المُخرج من (MAP) هو $\mathrm{MultiheadedAttention}(Q, V, V)$، حيث أن $q$ هو متجه استعلام (query vector) قابل للتدريب، و $V$ عبارة عن مصفوفة صفوفها هي $x_1, x_2, \dots, x_n$. اُقترح هذا لأول مرة في معمارية محول المجموعات (Set Transformer).
ومن ناحية أخرى، بعد أن يعالج محول الرؤية (ViT) صورة ما، فإنه ينتج بعض متجهات التضمين. يجب تحويل هذه المتجهات إلى توقع احتمالي لفئة واحدة بواسطة نوع ما من الشبكات. في محول الرؤية الأصلي والمشفر التلقائي المقنع، استعملوا رمزاً وهمياً [CLS]، محاكاةً للنموذج اللغوي بيرت (BERT). المُخرَج عند [CLS] هو رمز التصنيف، والذي تتم معالجته لاحقًا بواسطة وحدة تتكون من تسوية الطبقة (LayerNorm)، وتغذية أمامية (feedforward)، ودالة سوفت ماكس (softmax) لتحويله إلى توزيع احتمالي.
ومن ناحية أخرى، تم اقتراح إعادة الانتباه (Re-attention) للسماح بتدريب محولات رؤية (ViT) عميقة. وهي تقوم بتغيير وحدة الانتباه متعددة الرؤوس.
وعلى صعيد آخر، التجميع المتوسط العالمي (GAP) لا يستعمل الرمز الوهمي، بل يأخذ ببساطة متوسط جميع رموز المخرجات كرمز للتصنيف. وقد ذُكر في ورقة محول الرؤية (ViT) الأصلية أنه يمتلك نفس الفعالية.
التجميع (Pooling)
المشفر التلقائي المقنع (Masked Autoencoder)
شبكة عصبية التفافية
- انتباه (تعلم الآلة)
- تعلم عميق
- باي تورش
- تنسر فلو
- المراجع
التوقع
محول تايمز (TimeSformer)
من جهة ثانية، الاستخدامات والمشتقات تم استكشاف الكثير من المشتقات (أو المتغيرات) للمشفر التلقائي المقنع (MAE) الأصلي. تم تطبيق MAE للتدريب المسبق ذاتي الإشراف في السياقات الطبية، بما في ذلك تفسير صور الأشعة السينية للصدر. وقد طُبقت مشتقات MAE في هذا السياق لتكون بمثابة أداة تدريب مسبق أفضل للمجال الطبي.المشفر التلقائي المقنع الخاضع للإشراف الطبي (Medically Supervised MAE): يسعى المشفر التلقائي المقنع الخاضع للإشراف الطبي إلى معالجة مسألة تطبيق نسب التقنيع العالية لـ MAE عند استخدامه على مجموعات بيانات الآفات الطبية، ويستعمل مجموعة تدريب خاضعة للإشراف لإنشاء خرائط انتباه محلية للصور الطبية من أجل تقييد الرقع التي يتم إخفاؤها. حقق هذا النموذج أداءً ريادياً (اعتباراً من يناير 2025) في تصنيف الآفات الطبية على مجموعات بيانات Messidor-2 و BTMD و HAM10000 و DeepLesion و ChestXRay2017.المشفر التلقائي المقنع المستند إلى مصفوفة التواجد المشترك للمستوى الرمادي (GLCM-MAE): يستعمل GCLM-MAE مصفوفة التواجد المشترك لاستخراج معلومات الملمس من الصور من أجل الحفاظ عليها. وهو يعالج المشكلة التي يقوم فيها MAE الكلاسيكي بتنعيم الصور بشكل مفرط، مما يتسبب في فقدان التفاصيل الدقيقة التي قد تكون مهمة في السياقات الطبية. حقق GLCM-MAE أداءً متطوراً في تحديد سرطان المرارة، وسرطان الثدي المصور بالموجات فوق الصوتية، والالتهاب الرئوي المصور بالأشعة السينية، وكوفيد-19 المصور بالتصوير المقطعي المحوسب اعتباراً من يوليو 2025.المشفر التلقائي المقنع المدرك للمنطقة (Region-aware MAE أو R-MAE): يستبدل R-MAE خطوة توليد الرقع في MAE الأصلي بخوارزمية لتعيين وحدات البكسل الفردية لمناطق الاهتمام (regions of interest) في الصورة، والتي يتم تقنيعها معاً. تُعد معمارية تشفير المنطقة مستقلة بحد ذاتها، ولكن يمكن دمجها مع MAE لإعادة بناء المنطقة.المشفرات التلقائية المقنعة السيامية (SiamMAE): SiamMAE هي شبكة مصممة لتطبيق المشفرات التلقائية المقنعة على بيانات الفيديو. تأخذ عينتين (إطارين) من مقطع فيديو (مقارنة بإطار واحد في MAE الأصلي)، وتسميهما "الماضي" و"المستقبل". تقوم الشبكة بإخفاء غالبية الرقع (~95%) في إطار المستقبل، وتترك إطار الماضي دون مساس، وتمرر كليهما عبر كتلة مشفر MAE. يتم استبدال معمارية فك التشفير بكتل انتباه تقوم بتعيين الرقع من إطار الماضي إلى إطار المستقبل لإعادة البناء. يحقق SiamMAE أداءً تنافسياً مقارنة بالنماذج الأكبر في مهام التجزئة والانتشار في مقاطع الفيديو.نُشرت معمارية مشابهة بالتزامن تحت اسم BERT ViT (BEiT).=== DINO ===مثل المشفر التلقائي المقنع، تُعد طريقة DINO (التقطير الذاتي بدون تسميات - self-distillation with no labels) وسيلة لتدريب محول الرؤية (ViT) من خلال الإشراف الذاتي. يُعد DINO شكلاً من أشكال التقطير الذاتي بين المعلم والطالب. في DINO، يكون الطالب هو النموذج نفسه، والمعلم هو المتوسط الأسي للحالات السابقة للطالب. هذه الطريقة مشابهة لأعمال سابقة مثل التباين الزخمي (momentum contrast) وبناء المساحة الكامنة الخاصة بك (BYOL). دالة الخسارة المستعملة في DINO هي خسارة الإنتروبيا المتقاطعة بين مخرجات شبكة المعلم ($f_{\theta'_t}$) ومخرجات شبكة الطالب ($f_{\theta_t}$). شبكة المعلم هي متوسط متدهور أسياً للمعلمات السابقة لشبكة الطالب: $\theta'_t = \alpha \theta_t + \alpha(1-\alpha) \theta_{t-1} + \cdots$. المدخلات للشبكات عبارة عن قصتين مختلفتين (crops) لنفس الصورة، مُمثلتين بـ $T(x)$ و $T'(x)$، حيث $x$ هي الصورة الأصلية. تُكتب دالة الخسارة على النحو التالي:$$L(f_{\theta'_t}(T(x)), f_{\theta_t}(T'(x)))$$تتمثل إحدى المشكلات في أن الشبكة يمكن أن "تنهار" من خلال إخراج نفس القيمة دائماً ($y$)، بغض النظر عن المدخلات. لمنع هذا الانهيار، يستعمل DINO استراتيجيتين:الشحذ (Sharpening): يتم شحذ مخرجات شبكة المعلم باستخدام دالة سوفت ماكس (softmax) بدرجة حرارة أقل. هذا يجعل المعلم أكثر "ثقة" في توقعاته، مما يجبر الطالب على تعلم تمثيلات ذات مغزى أكبر لمطابقة مخرجات المعلم المشحوذة.التمركز (Centering): يتم تمركز مخرجات شبكة المعلم عن طريق حساب متوسطها مع مخرجاتها السابقة. يمنع هذا المعلم من التحيز تجاه أي قيمة مخرجات معينة، مما يشجع الطالب على تعلم مجموعة أكثر تنوعاً.
في هذا الإطار، الفكرة هي نفسها أساساً المشفر التلقائي المتغير المكمم متجهياً (VQVAE) فضلًا عن شبكة توليدية تنافسية (GAN).
في هذا الإطار، في مرحلة التوقع (Prediction)، يتم التخلص من معمارية فك التشفير بالكامل. يتم تقسيم الصورة المدخلة إلى رقع بواسطة نفس الخوارزمية المستعملة في التدريب، ولكن لا يتم تقنيع (إخفاء) أي رقع. يتم تطبيق إسقاط خطي مع تضمين موضعي على كل رقعة، ويتم إدخال تمثيلات متجه التضمين الناتجة لكل رقعة إلى المشفر.
كذلك، بدلاً من إجراء الانتباه الذاتي على التسلسل الكامل للرموز (رمز لكل رقعة)، فإنه يطبق انتباهاً ذاتياً "قائماً على النوافذ المُزاحة"، مما يعني إجراء الانتباه فقط على كتل مربعة الشكل من الرقع. تعتبر كتلة واحدة من الرقع مماثلة لمجال الاستقبال (receptive field) لعملية التفاف واحدة.
محول سوين (Swin Transformer)
كذلك، في يناير 2024، أصدرت أبحاث ميتا (Meta AI Research) نسخة محدثة تسمى DINOv2 مع تحسينات في المعمارية، ودالة الخسارة، وتقنية التحسين. تم تدريبها على مجموعة بيانات أكبر وأكثر تنوعاً. كانت الميزات التي تعلمها DINOv2 أكثر قابلية لـ النقل، مما يعني أن أداءها كان أفضل في المهام اللاحقة.في أغسطس 2025، أصدرت أبحاث ميتا DINOv3، وهو تحديث لـ DINOv2. وقد قدم محاذاة الصورة مع النص بشكل مشابه لنموذج CLIP. قام بتوسيع نطاق النموذج إلى 7 مليارات معلمة ومجموعة بيانات التدريب إلى 1.7 مليار صورة (تم الحصول عليها عن طريق أخذ عينات التنوع لمجموعة بيانات أولية تحتوي على 17 مليار صورة). من الناحية المعمارية، قدم تحسينين: إرساء جرام (Gram anchoring) و التضمينات الموضعية الدوارة المحورية (axial RoPE) مع الارتعاش (jittering). يطبق إرساء جرام التقطير الذاتي بين المعلم والطالب لـ مصفوفة جرام بين متجهات الميزات لرقع الصورة. ويتجنب هذا المشكلة التي لوحظت سابقاً والمتمثلة في تدهور خرائط الميزات الكثيفة: فبينما استمر الأداء في المهام العالمية (مثل التصنيف) في التحسن، فإن الأداء في المهام الكثيفة (مثل التجزئة) كان يصل إلى ذروته مبكراً ثم يتراجع، لتصبح خرائط الميزات صاخبة. بينما يجعل (Axial RoPE) النموذج أكثر قوة في التعامل مع درجات الدقة، والمقاييس، ونسب العرض إلى الارتفاع المتفاوتة للصور.
وفي السياق ذاته، في معمارية ViT-VQGAN، يوجد مشفران (encoders) من نوع ViT ومُميِّز (discriminator). يقوم أحدهما بتشفير رقع 8×8 من الصورة إلى قائمة من المتجهات، بمعدل متجه واحد لكل رقعة. يمكن أن تأتي المتجهات فقط من مجموعة منفصلة من "دفتر الشفرات" (codebook)، كما هو الحال في التكميم المتجهي. ويقوم الآخر بتشفير المتجهات المُكممة (quantized vectors) مرة أخرى إلى رقع صور. يحاول هدف التدريب جعل الصورة المُعاد بناؤها (الصورة المُخرجة) مطابقة تماماً للصورة المُدخلة. بينما يحاول المُميِّز (وعادةً ما يكون شبكة التفافية، ولكن يُسمح بشبكات أخرى) تحديد ما إذا كانت الصورة أصلية حقيقية، أم صورة أُعيد بناؤها بواسطة ViT.
إضافةً إلى ذلك، صُمم محول TimeSformer لمهام فهم الفيديو، وطبق انتباهاً ذاتياً مُحللاً (factorized self-attention)، مشابهاً لنويات الالتفاف المُحللة الموجودة في معمارية إنسبشن (Inception) للشبكات العصبية الالتفافية. من الناحية التخطيطية، فإنه يقسم الفيديو إلى إطارات، وكل إطار إلى شبكة مربعة من الرقع (نفس طريقة ViT). لنفترض أن إحداثيات كل رقعة يُشار إليها بـ $x, y, t$، والتي تمثل الأفقي والعمودي والزمن.
وفي السياق ذاته، طبقة الانتباه المكاني هي طبقة انتباه ذاتي حيث تنتبه كل رقعة استعلام $q_{x, y, t}$ فقط لرقع المفتاح والقيمة $k_{x', y', t'}, v_{x', y', t'}$ بحيث يكون $t = t'$.
وفي هذا السياق، نظر محول TimeSformer كذلك في تصميمات أخرى لطبقات الانتباه، مثل "طبقة انتباه الارتفاع" حيث يكون الشرط $x' = x, t' = t$. ومع ذلك، وجدوا تجريبياً أن أفضل تصميم هو الذي يدمج (يُقاطع) بين طبقة انتباه مكاني واحدة وطبقة انتباه زماني واحدة بالتناوب.
محول الرؤية والشبكة التوليدية التنافسية المكممة (ViT-VQGAN)
من جانب آخر، بعد كل بضع كتل انتباه، توجد "طبقة دمج" (merge layer)، والتي تدمج الرموز المتجاورة بحجم 2×2 في رمز واحد. هذا مشابه لعملية التجميع (بواسطة نويات التفاف 2×2، مع خطوة stride تساوي 2). الدمج يعني التسلسل (concatenation) متبوعاً بالضرب في مصفوفة.
وفي هذا السياق، طبقة الانتباه الزماني هي حيث يكون الشرط $x' = x, y' = y$ بدلاً من ذلك.
علاوةً على ذلك، استوحى محول سوين (النوافذ المُزاحة أو "Shifted windows") فكرته من الشبكات العصبية الالتفافية (CNNs) القياسية:
من جهة ثانية، تم تحسين هذا النموذج بواسطة الإصدار الثاني (Swin Transformer V2)، والذي يُعدل على محول الرؤية (ViT) بآلية انتباه مختلفة
من جهة ثانية، بعد تدريب ViT-VQGAN هذا، يمكن استخدامه لتشفير أي صورة عشوائية إلى قائمة من الرموز، وتشفير أي قائمة عشوائية من الرموز إلى صورة. يمكن استخدام قائمة الرموز لتدريب محول قياسي ذاتي الانحدار (autoregressive transformer مثل GPT)، لتوليد صورة بشكل ذاتي الانحدار. علاوة على ذلك، يمكن للمرء أن يأخذ قائمة من أزواج (تعليق توضيحي - صورة)، وتحويل الصور إلى سلاسل من الرموز، وتدريب محول قياسي بأسلوب GPT. ثم في وقت الاختبار، يمكن الاكتفاء بإعطاء تعليق توضيحي للصورة، لكي يقوم النموذج بتوليد الصورة بشكل ذاتي الانحدار. هذا هو الهيكل الذي يعتمده نموذج بارتي (Parti) من جوجل.
نظرة عامة
من جهة ثانية، البنية الأساسية، المستعملة في ورقة 2020 الأصلية، هي كما يلي: وخلاصة الأمر أنها محول قائم على المُرمِّز فقط، شبيه بـBERT (نموذج لغوي).
من جهة ثانية، وبالنسبة إلى كل رقعة، تُمرَّر الرقعة عبر مؤثر خطي للحصول على متجه («تضمين الرقعة»). كما يُحوَّل موضع الرقعة كذلك إلى متجه بواسطة «ترميز الموضع». ثم يُجمع المتجهان، وفيما بعد يُمران عبر عدة مُرمِّزات محول.
إضافةً إلى ذلك، وتحوّل آلية الانتباه في ViT تمثيلات رقع الصورة مرارًا، مع دمج المزيد والمزيد من العلاقات الدلالية بين رقع الصورة داخل الصورة. وهذا مماثل لما يحدث في معالجة اللغات الطبيعية، حيث إن متجهات التمثيل، كلما تدفقت عبر المحول، دمجت مزيدًا من العلاقات الدلالية بين الكلمات، من النحو إلى الدلالة.
من جانب آخر، فمثلًا، لاستخدامه في التصنيف، يمكن إضافة MLP ضحل فوقه يُخرج توزيعًا احتماليًا على الفئات. وتستعمل الورقة الأصلية شبكة من نمط خطي-GeLU-خطي-سوفتماكس.
علاوةً على ذلك، تكون صورة الإدخال من النوع ، حيث إن تمثل الارتفاع والعرض والقناة (RGB). ثم تُقسّم إلى رقع مربعة الشكل من النوع .
إضافةً إلى ذلك، وتحوّل البنية السابقة الصورة إلى سلسلة من التمثيلات المتجهية. ولاستخدام هذه التمثيلات في التطبيقات النهائية، يلزم تدريب رأس إضافي لتفسيرها.
التدريب
من جانب آخر، أثناء التدريب، يتم تقسيم الصور المدخلة (224 × 224 بكسل في التنفيذ الأصلي) على طول عدد محدد من الخطوط على كل محور، مما ينتج عنه رقع للصور. يتم تحديد نسبة معينة من الرقع ليتم إخفاؤها (قناعها) بواسطة رموز التقنيع، بينما يتم الاحتفاظ بجميع الرقع الأخرى في الصورة. تُكلف الشبكة بمهمة إعادة بناء الصورة من الرقع المتبقية غير المقنعة. رموز التقنيع في التنفيذ الأصلي عبارة عن كميات متجهة قابلة للتعلم. يتم لاحقًا تطبيق إسقاط خطي مع التضمينات الموضعية على متجه الرقع غير المقنعة. وجدت التجارب التي غيرت نسبة التقنيع على الشبكات المدربة على مجموعة بيانات ImageNet-1K أن نسب التقنيع البالغة 75% حققت أداءً عالياً في كل من الضبط الدقيق (finetuning) والسبر الخطي (linear-probing) لـ الفضاء الكامن الخاص بالمشفر. يعالج المشفر التلقائي المقنع (MAE) الرقع غير المقنعة فقط أثناء التدريب، مما يزيد من كفاءة معالجة البيانات في المشفر ويقلل من استخدام الذاكرة لـ المحول.
ومن جهة أخرى، يُستعمل محول رؤية (ViT) أقل كثافة من الناحية الحسابية في وحدة فك التشفير في التنفيذ الأصلي لـ MAE. تتم إضافة الرقع المقنعة مرة أخرى إلى مخرجات كتلة المشفر كرموز تقنيع، ويتم إدخال كليهما إلى وحدة فك التشفير. يتم حساب خسارة إعادة البناء (reconstruction loss) للرقع المقنعة لتقييم أداء الشبكة.
التطبيقات
وفي السياق ذاته، أُثبت أن نموذج DINO يتعلم تمثيلات مفيدة لتجميع الصور (clustering) واستكشاف الملامح المورفولوجية في مجموعات البيانات البيولوجية، مثل الصور التي تم إنشاؤها باستخدام فحص تلوين الخلايا (Cell Painting).
إضافةً إلى ذلك، استُخدمت محولات الرؤية (ViT) لتوليد الصور كشبكات أساسية (backbones) لـ الشبكات التوليدية التنافسية (GAN) ولـ نماذج الانتشار (محول الانتشار، أو DiT).
وعلى صعيد آخر، استُخدمت محولات الرؤية (ViT) في الكثير من مهام الرؤية الحاسوبية بنتائج ممتازة، وفي بعض الحالات حققت أداءً ريادياً (state-of-the-art)، كما هو الحال في تصنيف الصور، واكتشاف الكائنات، واكتشاف التزييف العميق في مقاطع الفيديو، وتجزئة الصورة، واكتشاف الشذوذ (anomaly detection)، وتوليد الصور (image synthesis)، والتحليل العنقودي، والقيادة الذاتية.
من جانب آخر، في عام 2024، صُمم نموذج ViT بـ 113 مليار معلمة (وهو أكبر محول رؤية حتى الآن) لـ التنبؤ بالطقس والمناخ، وتم تدريبه على الحاسوب العملاق فرونتير (Frontier) بإنتاجية بلغت 1.6 إكسا فلوب (exaFLOPs).
📝 هل في هذه المقالة خطأ؟
إذا وجدت معلومة تحتاج تصحيحاً أو إضافة، أو أردت حذف المقالة، أرسل لنا طلباً وسنراجعه.
ما رأيك في هذه المقالة؟